Materiał przygotowany z pomocą AI
Treść tego wpisu powstała z wykorzystaniem sztucznej inteligencji. Wszystkie bloki kodu zostały wykonane i zweryfikowane na rzeczywistych danych, a wyniki liczbowe pochodzą z tych wykonań.
Badanie jednorodności przepływów w Pythonie — studium przypadku
Wpis Badanie jednorodności ciągów hydrologicznych opisuje teorię, tj. testy statystyczne i pełną procedurę obliczeniową (Ozga-Zieliński / IMGW). Tutaj przechodzimy do praktyki i krok po kroku, na prawdziwych danych, zbudujemy cały kod w Pythonie:
- pobierzemy roczne przepływy z IMGW za pomocą biblioteki IMGWTools,
- każdy test zaimplementujemy najpierw ręcznie (żeby było widać, skąd bierze się wynik), a potem pokażemy gotową funkcję biblioteczną (
scipy,pandas,pymannkendall), - wyniki zinterpretujemy.
Bloki kodu mają formę zbliżoną do notatnika Jupyter i są gotowe do wykorzystania w nim. Są one kumulatywne, więc kolejne bloki mogą korzystać z danych generowanych przez wcześniejsze.
Środowisko do uruchomienia
Bloki kodu zweryfikowano w Pythonie 3.12.12 z pakietami:
imgwtools 2.1.1,numpy 2.4.4,pandas 3.0.2,scipy 1.18.0,matplotlib 3.10.9,pymannkendall 1.4.3. Pełna instrukcja odtworzenia środowiska: Środowisko Python dla przykładów.
Co warto wiedzieć przed rozpoczęciem
Zakładamy znajomość podstaw statystyki (średnia, mediana, wariancja, ranga, poziom istotności , hipoteza zerowa) oraz podstaw Pythona i pandas. Znaczenie i wzory poszczególnych testów wyjaśnia wpis teoretyczny Badanie jednorodności ciągów hydrologicznych — tutaj skupiamy się na obliczeniach.
1. Po co badać jednorodność
Analiza częstości (dopasowanie rozkładu i wyznaczanie przepływów o zadanym prawdopodobieństwie) zakłada, że ciąg pomiarowy jest jednorodny: wszystkie pomiary przepływu pochodzą z tego samego rozkładu i są niezależne. Jeśli w trakcie obserwacji zmienił się reżim rzeki — powstał zbiornik, zmieniono metodę pomiaru, przesunięto wodowskaz — ciąg przestaje być jednorodny, a wyznaczone kwantyle są obarczone błędem.
Badanie jednorodności to więc kontrola jakości danych wykonywana przed właściwą analizą. W polskiej praktyce [IMGW, 2022] składa się z dwóch etapów:
- Etap I — analiza genetyczna (jakościowa): co wiemy o zlewni i stacji z historii, map i dokumentów.
- Etap II — analiza statystyczna (ilościowa): sekwencja testów na samym ciągu liczb.
Przejdziemy przez oba etapy na konkretnym przykładzie.
2. Trzy wodowskazy na Kamiennej
Kamienna to karkonoski dopływ Bobru. Wybieramy trzy wodowskazy IMGW leżące na niej w układzie podłużnym (od źródeł w dół):
| Wodowskaz | Kod IMGW | Charakter |
|---|---|---|
| Jakuszyce | 150150030 | najbliższy naturalnemu, stacja odniesienia |
| Piechowice | 150150050 | powyżej jazy MEW Szklarska Poręba I i II |
| Jelenia Góra | 150150070 | powyżej suche zbiorniki i regulacja |
Taki układ jest dydaktycznie wygodny: stacja górna służy za punkt odniesienia, a stacje niższe są narażone na antropopresję.
Analizować będziemy maksymalny roczny przepływ (WQ) — najwyższy przepływ w roku hydrologicznym. Jest to zmienna kluczowa dla ochrony przeciwpowodziowej i wrażliwa na zbiorniki retencyjne (które ścinają kulminacje).
Rok hydrologiczny
W Polsce rok hydrologiczny trwa od 1 listopada do 31 października i nosi numer roku kalendarzowego, w którym się kończy. Dane IMGW są indeksowane rokiem hydrologicznym.
3. Pobranie danych z IMGW
Wszystkie potrzebne pakiety są już w opisanym środowisku — nie instalujemy niczego osobno. Do pobierania danych służy IMGWTools: sięga po publiczne dane z portalu danepubliczne.imgw.pl. Interesuje nas archiwum półroczne i roczne dla parametru Q (przepływ) — zawiera ono dla każdej stacji i roku hydrologicznego ekstrema półroczy.
Wszystkie importy zbieramy w jednym miejscu, na samej górze — dalsze bloki korzystają już z tych bibliotek:
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# biblioteki naukowe wykorzystywane w testach (sekcja 5)
from scipy.stats import (
    norm, t as t_dist, chi2 as chi2_dist, rankdata, kruskal, spearmanr,
)
import pymannkendall as mk

# pobieranie danych hydrologicznych IMGW
from imgwtools import download_hydro_data, parse_zip_file
Pobierzmy najpierw archiwum ZIP dla jednego rocznika, żeby zobaczyć, z czym pracujemy:
# download_hydro_data zwraca archiwum ZIP dla wszystkich stacji hydrologicznych
zip_2023 = download_hydro_data("polroczne_i_roczne", 2023, param="Q")
print(type(zip_2023), len(zip_2023), "bajtów")
<class 'bytes'> 58809 bajtówParsowanie danych
Zamiast rozpakowywać CSV ręcznie, użyjemy funkcji parse_zip_file z IMGWTools — rozpakowuje ona archiwum i zwraca pary (stacja, rekord) jako obiekty. Zobaczmy jeden rekord dla stacji Jelenia Góra (kod 150150070):
station, record = next(
    (s, r) for s, r in parse_zip_file(zip_2023, "polroczne_i_roczne")
    if r.station_code == "150150070"
)
print(record)
station_code='150150070' station_name=None river_name=None hydro_year=2023 period='winter' param='Q' extremum='min' value=0.69 extremum_start_date='2022-12-13' extremum_end_date=NoneInteresują nas trzy pola: period ("winter" = półrocze zimowe XI–IV, "summer" = letnie V–X, "annual" = rok), extremum ("min", "mean", "max") oraz value (wartość w m³/s; brak danych zwracany jest jako None).
Niespójny format plików IMGW
Archiwalne pliki CSV z IMGW mają różny separator w różnych rocznikach — większość używa przecinka z cudzysłowami, część (np. rocznik 2023) średnika, a niektóre roczniki mają dodatkowo wiersz nagłówka. Od wersji IMGWTools 2.1.1
parse_zip_filewykrywa separator automatycznie, więc ta różnorodność jest dla nas obojętna. Gdyby biblioteka zwracała0rekordów, masz starszą wersję — zaktualizuj:pip install -U imgwtools.
Od półroczy do maksimum rocznego
Plik nie podaje maksimum rocznego wprost — dla całego roku (period="annual") jest tylko średnia. Maksima i minima są półroczne. Wypiszmy ekstrema Q dla Jeleniej Góry za 2023 rok — po jednej wartości na parę (półrocze, ekstremum):
# w surowym pliku maksimum bywa w kilku wierszach (kulminacja trzymała się przez kilka
# odczytów), a średnie nie mają daty — słownik (półrocze, ekstremum) usuwa powtórzenia
extrema = {}
for s, r in parse_zip_file(zip_2023, "polroczne_i_roczne"):
    if r.station_code == "150150070":
        extrema[(r.period, r.extremum)] = r.value

for (period, extremum), value in extrema.items():
    print(f"{period:7} {extremum:5} {value}")
winter min 0.69
winter mean 5.83
winter max 40.0
summer min 0.7
summer mean 2.51
summer max 40.7
annual mean 4.16Skąd powtórzenia i puste daty w surowym pliku
Bez deduplikacji
winter max 40,0pojawiłoby się trzykrotnie — IMGW zapisuje ekstremum osobno dla każdego odczytu, w którym padło, a kulminacja 40,0 m³/s utrzymała się przez trzy pomiary 15.04.2023 (06:10, 06:30, 06:50). Wartości średnie z kolei nie mają momentu wystąpienia, więc data jest pusta (None). Słownik(półrocze, ekstremum) → wartośćbierze po jednej wartości na parę, więc jedno i drugie znika. Dla samego WQ powtórzenia i tak są bez znaczenia (liczymymax), ale przy sumie albo liczbie przekroczeń progu trzeba je usunąć — inaczej zawyżą wynik.
Maksimum roczne to większe z dwóch maksimów półrocznych:
STATIONS = {
    "150150030": "Jakuszyce",
    "150150050": "Piechowice",
    "150150070": "Jelenia Góra",
}
def fetch_wq(code_names, year_from, year_to):
"""Buduje ramkę rocznych maksimów WQ dla podanych stacji i lat."""
records = []
for year in range(year_from, year_to + 1):
try:
zip_bytes = download_hydro_data(
"polroczne_i_roczne", year, param="Q", timeout=60
)
except Exception as e: # np. rok jeszcze nieopublikowany
print(f"{year}: pominięto ({type(e).__name__})")
continue
maxima = {code: [] for code in code_names}
for station, record in parse_zip_file(zip_bytes, "polroczne_i_roczne"):
if (record.station_code in code_names
and record.extremum == "max"
and record.value is not None):
maxima[record.station_code].append(record.value)
for code, values in maxima.items():
if values:
records.append({"kod": code, "stacja": code_names[code],
"rok": year, "wq": max(values)})
return pd.DataFrame(records)# Pobranie zajmuje chwilę, więc wynik zapisujemy do CSV
# i przy kolejnych uruchomieniach czytamy z dysku.
path = Path("kamienna_wq.csv")
if path.exists():
df = pd.read_csv(path)
else:
df = fetch_wq(STATIONS, 1951, 2024)
df.to_csv(path, index=False, encoding="utf-8")
print(df.shape)
print(df.groupby("stacja").rok.agg(["min", "max", "count"]))(172, 4)
min max count
stacja
Jakuszyce 1981 2024 44
Jelenia Góra 1961 2024 64
Piechowice 1961 2024 64Mamy komplet: Piechowice i Jelenia Góra 1961–2024 (64 lata), Jakuszyce 1981–2024 (44 lata), bez brakujących danych. Długość ciągów spełnia z zapasem zalecenie metodyki KZGW ().
Przekształćmy dane do postaci „szerokiej” (rok × stacja), wygodnej do analizy i wykresów:
wq = df.pivot(index="rok", columns="stacja", values="wq")[
    ["Jakuszyce", "Piechowice", "Jelenia Góra"]
]
print(wq.tail(8).round(1).to_string())
stacja Jakuszyce Piechowice Jelenia Góra
rok
2017 6.7 51.1 39.5
2018 2.6 15.5 19.2
2019 3.4 25.4 44.0
2020 5.4 38.9 50.9
2021 6.7 39.4 59.0
2022 5.0 27.8 34.8
2023 4.4 29.9 40.7
2024 13.1 97.2 227.0print(wq.describe().round(1).to_string())stacja Jakuszyce Piechowice Jelenia Góra
count 44.0 64.0 64.0
mean 7.8 45.0 68.1
std 9.1 26.6 42.4
min 2.3 15.5 19.2
25% 4.5 28.2 40.6
50% 5.4 38.0 55.1
75% 6.9 51.1 80.0
max 56.3 169.0 227.0Przepływy rosną w dół biegu (mediany 5,4; 38,0; 55,1 m³/s), co potwierdza układ podłużny. Rok 2024 wyróżnia się gwałtownie (Jelenia Góra 227 m³/s) — to powódź z września 2024.
4. Ocena wizualna i analiza genetyczna (Etap I)
Wykres serii
Pierwszy krok każdej analizy to wykres. Skala logarytmiczna jest tu całkiem wygodna, bo przepływy maksymalne obejmują ponad rząd wielkości.
fig, ax = plt.subplots(figsize=(11, 5.5))
for station, color in zip(wq.columns, ["#2ca02c", "#1f77b4", "#d62728"]):
    ax.plot(wq.index, wq[station], marker="o", ms=3, lw=1.2, label=station, color=color)
ax.set_yscale("log")
ax.set_xlabel("rok hydrologiczny")
ax.set_ylabel("WQ [m³/s] (skala log)")
ax.set_title("Maksymalny roczny przepływ — Kamienna")
ax.legend()
ax.grid(True, which="both", alpha=0.3)
fig.tight_layout()
plt.show()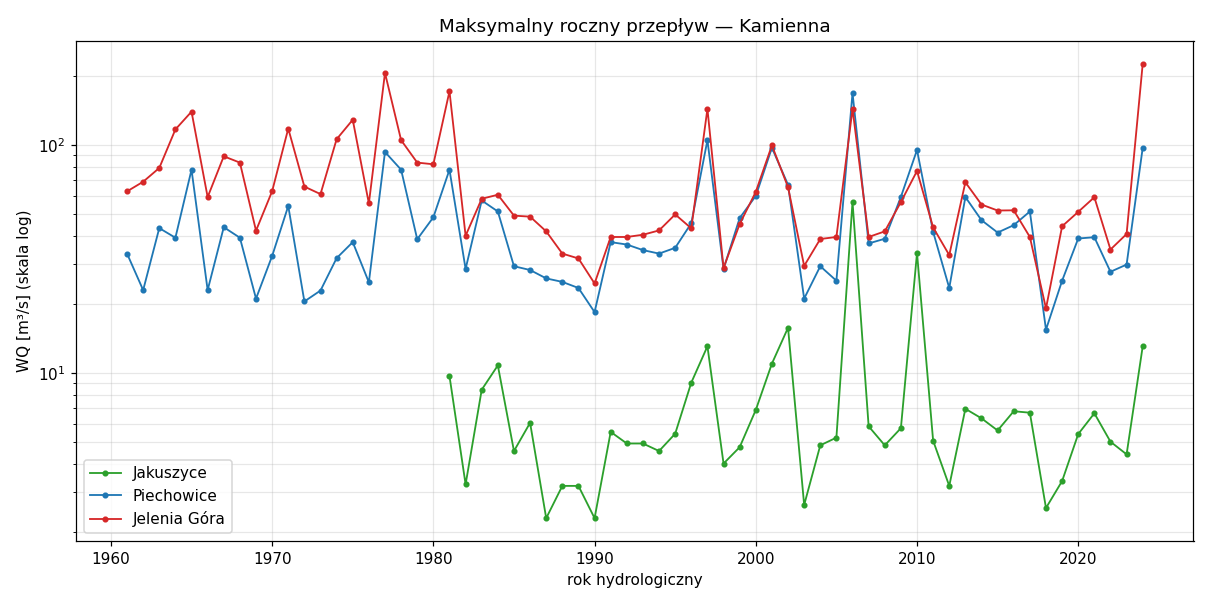
Na wykresie rzuca się w oczy jedna rzecz: do około 1981 roku Jelenia Góra (czerwony) leży wyraźnie wyżej niż Piechowice (niebieski), a od lat 90/00. obie serie niemal się pokrywają. To pierwsza przesłanka niejednorodności lokalnej, dotyczącej tylko dolnej stacji. W latach 1986-2021 budowany był zbiornik retencyjny Sosnówka na Czerwonce, która uchodzi do Podgórnej, ta dalej do Wrzosówki, która jest dopływem Kamiennej.
Porównanie ze stacją odniesienia
Jelenia Góra leży poniżej Piechowic, więc jej zlewnia jest większa i maksima powinny być wyraźnie wyższe. Policzmy stosunek maksimów:
ratio = wq["Jelenia Góra"] / wq["Piechowice"]
for lo, hi in [(1961, 1981), (1982, 2024)]:
    period = ratio[(ratio.index >= lo) & (ratio.index <= hi)]
    print(f"{lo}-{hi}: średni stosunek Jelenia Góra / Piechowice = {period.mean():.2f}")
1961-1981: średni stosunek Jelenia Góra / Piechowice = 2.32
1982-2024: średni stosunek Jelenia Góra / Piechowice = 1.25Stosunek spada z 2,3 do ~1,25 — po 1982 dolny wodowskaz notuje kulminacje niewiele wyższe niż stacja o wiele mniejszej zlewni powyżej. Potwierdza to krzywa podwójnie kumulowana (ang. double-mass curve): wykres skumulowanych maksimów jednej stacji względem drugiej powinien być linią prostą, a załamanie nachylenia wskazuje niejednorodność.
common = wq[["Piechowice", "Jelenia Góra"]].dropna()
cx = common["Piechowice"].cumsum()
cy = common["Jelenia Góra"].cumsum()

early = common.index <= 1981
late = common.index >= 1982
slope_early = np.polyfit(cx[early], cy[early], 1)[0]
slope_late = np.polyfit(cx[late], cy[late], 1)[0]
print(f"nachylenie krzywej 1961-1981: {slope_early:.2f}")
print(f"nachylenie krzywej 1982-2024: {slope_late:.2f}")
nachylenie krzywej 1961-1981: 2.25
nachylenie krzywej 1982-2024: 1.10Zobaczmy to na wykresie — krzywa podwójnie kumulowana powinna być prostą; jej złamanie wskazuje na niejednorodność:
fig, ax = plt.subplots(figsize=(6.5, 6.5))
ax.plot(cx, cy, "o-", ms=3, lw=1, color="#444", label="suma skumulowana (rok po roku)")
ax.plot(cx[early], np.polyval(np.polyfit(cx[early], cy[early], 1), cx[early]),
        "--", color="#d62728", lw=1.6, label="dopasowanie 1961–1981 (nachylenie 2,25)")
ax.plot(cx[late], np.polyval(np.polyfit(cx[late], cy[late], 1), cx[late]),
        "--", color="#1f77b4", lw=1.6, label="dopasowanie 1982–2024 (nachylenie 1,10)")
ax.annotate("załamanie ~1982", xy=(cx.loc[1981], cy.loc[1981]),
            xytext=(cx.loc[1981] * 1.25, cy.loc[1981] * 0.9),
            arrowprops=dict(arrowstyle="->"), fontsize=9)

# obie osie: ten sam zakres od 0 i wspólna podziałka co 500
upper = 500 * int(np.ceil(max(cx.max(), cy.max()) / 500))
ax.set_xlim(0, upper)
ax.set_ylim(0, upper)
ax.set_xticks(np.arange(0, upper + 1, 500))
ax.set_yticks(np.arange(0, upper + 1, 500))
ax.set_aspect("equal")
ax.set_xlabel("skumulowane WQ Piechowice [m³/s]")
ax.set_ylabel("skumulowane WQ Jelenia Góra [m³/s]")
ax.set_title("Krzywa podwójnie kumulowana: Jelenia Góra względem Piechowic")
ax.legend(fontsize=8)
ax.grid(True, alpha=0.3)
fig.tight_layout()
plt.show()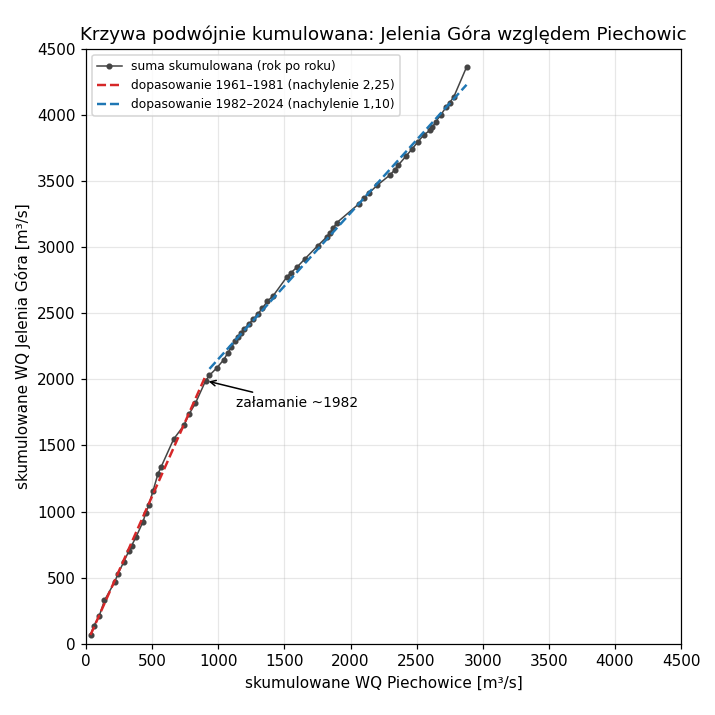
Nachylenie łamie się w stosunku 2:1 około 1982 roku — punkt załamania wypada tam, gdzie relacja maksimów obu stacji nagle się zmienia.
Analiza genetyczna (Etap I)
Zestawmy to z tym, co wiadomo o zlewni (Etap I). Powyżej wodowskazu Jelenia Góra istnieją budowle wpływające na przepływ, ale — co kluczowe — 2 z nich (suche zbiorniki) są starsze niż ciąg pomiarowy albo zbyt świeże, by tłumaczyć skok z 1982 roku, a 1 to zbiornik stale piętrzący wodę:
- suchy zbiornik przeciwpowodziowy Sobieszów na Kamiennej — obiekt historyczny (początek XX w.), ścina kulminacje od dziesięcioleci;
- suchy zbiornik Cieplice na Wrzosówce (dopływ Kamiennej powyżej Jeleniej Góry) — również z początku XX w.;
- zbiornik Sosnówka na Podgórnej — oddany na początku XXI w. (budowa w latach 1986-2001);
Żadna z tych dat nie wypada w okolicy 1982 roku. Co więcej, Piechowice powyżej nie wykazują analogicznej zmiany. Wytłumaczeniem mogłoby być częściowe retencjonowanie wezbrań przez zbiornik Sosnówka w trakcie jego budowy, ale nie jestem w stanie tego zweryfikować.
Hipoteza wymaga potwierdzenia
Przyczyny skoku z 1982 roku nie potwierdziliśmy — to hipoteza wysnuta z danych i logiki (zanik różnicy do stacji powyżej, brak nowych budowli w tym czasie). Rzetelny operat wymagałby sprawdzenia danych historycznych. W dalszej analizie traktujemy 1982 jako a priori wskazany punkt podziału.
Testy statystyczne wykrywają, że coś się zmieniło i kiedy — ale dlaczego, rozstrzyga dopiero analiza genetyczna.
5. Analiza statystyczna (Etap II)
Przechodzimy do sedna. Wykonujemy testy sekwencyjnie:
- Grubbs-Beck — wykrycie błędów grubych,
- test serii — niezależność (losowość),
- autokorelacja — korelacja wewnętrzna,
- Kruskal-Wallis — test sumy rang, stacjonarność rozkładu (podział a priori),
- Spearman — test na trend wartości średniej,
- Spearman na — test na trend wariancji.
Dodatkowo policzymy test Manna-Kendalla — to jedyny test jednorodności wskazany przez metodykę KZGW (2017) i nieparametryczny odpowiednik Spearmana.
Każdy test najpierw napiszemy ręcznie (wzory za wpisem Badanie jednorodności ciągów hydrologicznych, oznaczenia I.1–I.11 z monografii IMGW-PIB), a potem porównamy z gotową funkcją. Zaczynamy od wygodnego skrótu do wyciągania serii jednej stacji (importy mamy już z sekcji 3):
def series(name):
    """Zwraca (lata, wartości WQ) dla stacji, bez braków,
    w kolejności chronologicznej."""
    s = wq[name].dropna()
    return s.index.to_numpy(), s.to_numpy()
years_jg, jg = series("Jelenia Góra") # główny przykład — stacja z niejednorodnością
print("Jelenia Góra WQ:", len(jg), "lat,",
int(years_jg.min()), "-", int(years_jg.max()))Jelenia Góra WQ: 64 lat, 1961 - 2024Jako główny przykład bierzemy Jelenię Górę — to na niej możemy spodziewać się wystąpienia niejednorodności. Na końcu uruchomimy całą procedurę dla wszystkich trzech stacji.
5.1. Test Grubbsa-Becka (błędy grube)
Test szuka wartości odstających, które mogą być błędami grubymi. Zakłada, że logarytmy przepływów mają rozkład normalny, i wyznacza przedział ufności wokół średniej. Współczynnik zależy od liczebności (wzór dla , I.1):
def grubbs_beck(x):
    x = np.asarray(x, dtype=float)
    y = np.log(x)
    n = len(y)
    ybar, sy = y.mean(), y.std(ddof=1)
    K = (-3.62201 + 6.28446 * n**0.25 - 2.49835 * n**0.5
         + 0.491436 * n**0.75 - 0.037911 * n)
    yl, yu = ybar - K * sy, ybar + K * sy
    return dict(K=K, lower_threshold=np.exp(yl), upper_threshold=np.exp(yu),
                low=np.sort(x[y < yl]), high=np.sort(x[y > yu]))
result = grubbs_beck(jg)
print(f"K = {result['K']:.4f}")
print(f"przedział: [{result['lower_threshold']:.2f}, "
f"{result['upper_threshold']:.2f}] m³/s")
print(f"odstające niskie: {result['low']}")
print(f"odstające wysokie: {result['high']}")K = 2.8600
przedział: [13.41, 259.12] m³/s
odstające niskie: []
odstające wysokie: []Dla Jeleniej Góry żadna wartość nie wykracza poza przedział — nawet powódź 2024 (227 m³/s) mieści się poniżej progu 259 m³/s. To zgodne z zasadą, że rozkłady stosowane w hydrologii (log-normalny, Pearson III i inne) dopuszczają duże wartości, a odstającego maksimum nie usuwa się automatycznie.
Brak gotowej funkcji bibliotecznej
Test Grubbsa-Becka w tej postaci (współczynnik z monografii IMGW) nie ma bezpośredniego odpowiednika w
scipy. Klasyczny test Grubbsa (scipygo nie zawiera; bywa w pakietach zewnętrznych) usuwa jedno ekstremum naraz i zakłada normalność surowych danych — to inne narzędzie. Tutaj implementacja ręczna jest jedyną drogą.
5.2. Test serii (niezależność)
Test sprawdza, czy ciąg jest losowy. Każdą wartość oznaczamy symbolem w zależności od tego, czy leży powyżej, czy poniżej mediany, i liczymy serie — nieprzerwane bloki tego samego symbolu. Za mało serii oznacza „zlepianie się” (trend albo skok), za dużo — naprzemienność.
Wartość krytyczną można odczytać z tablic, ale dla ciągów o wygodne jest przybliżenie normalne (test Walda-Wolfowitza). Przy wartościach poniżej i powyżej mediany liczba serii ma:
def runs_test(x, alpha=0.05):
    x = np.asarray(x, dtype=float)
    median = np.median(x)
    s = x[x != median]  # elementy równe medianie pomijamy
    above = s > median
    n1 = int((~above).sum())  # poniżej mediany
    n2 = int(above.sum())  # powyżej mediany
    r = 1 + int((above[1:] != above[:-1]).sum())
    N = n1 + n2
    Er = 2 * n1 * n2 / N + 1
    Var = 2 * n1 * n2 * (2 * n1 * n2 - N) / (N**2 * (N - 1))
    Z = (r - Er) / np.sqrt(Var)
    p = 2 * (1 - norm.cdf(abs(Z)))
    return dict(r=r, n1=n1, n2=n2, E_r=Er, Z=Z, p=p, reject=p < alpha)
w = runs_test(jg)
print(f"liczba serii r = {w['r']} (oczekiwana E[r] = {w['E_r']:.1f})")
print(f"Z = {w['Z']:.4f}, p = {w['p']:.4f} -> odrzucić H0 o losowości: {w['reject']}")liczba serii r = 19 (oczekiwana E[r] = 33.0)
Z = -3.5281, p = 0.0004 -> odrzucić H0 o losowości: TrueZaledwie 19 serii przy oczekiwanych 33 — ciąg jest daleki od losowego. Wartości długo utrzymują się po jednej stronie mediany (wysokie do ~1981, niższe potem), co jest sygnaturą skoku. W ścisłej procedurze polskiej negatywny wynik testu serii kończy analizę: ciąg uznajemy za niejednorodny. My kontynuujemy w celach dydaktycznych.
Te liczby najłatwiej zrozumieć na wykresie. Pokolorujmy każdy rok według strony mediany i podświetlmy tłem kolejne serie — wtedy „za mało serii” przestaje być abstrakcją, bo bloki można policzyć:
med = np.median(jg)
above = jg > med
# granice serii: indeksy, w których ciąg zmienia stronę mediany
boundaries = (
    [0] + [i for i in range(1, len(jg)) if above[i] != above[i - 1]] + [len(jg)]
)

fig, ax = plt.subplots(figsize=(11, 5.5))
for s, e in zip(boundaries[:-1], boundaries[1:]):  # tło każdej serii wg strony mediany
    ax.axvspan(years_jg[s] - 0.5, years_jg[e - 1] + 0.5,
               color="#1f77b4" if above[s] else "#d62728", alpha=0.10, lw=0)
ax.plot(years_jg, jg, "-", color="grey", lw=0.8, alpha=0.6, zorder=2)
ax.scatter(years_jg[above],  jg[above],  color="#1f77b4", s=30, zorder=3,
           label="powyżej mediany")
ax.scatter(years_jg[~above], jg[~above], color="#d62728", s=30, zorder=3,
           label="poniżej mediany")
ax.axhline(med, color="black", ls="--", lw=1.1, zorder=2)
ax.text(years_jg[0] + 0.3, med, f"mediana = {med:.1f} m³/s".replace(".", ","),
        va="bottom", ha="left", fontsize=9)

_w = runs_test(jg)
p_str = f"{_w['p']:.4f}".replace(".", ",")
ax.set_title(f"Test serii — Jelenia Góra: r = {_w['r']} serii "
             f"wobec E[r] = {_w['E_r']:.0f}  →  "
             f"H₀ o losowości odrzucona (p = {p_str})", fontsize=10.5)
ax.set_xlabel("rok hydrologiczny"); ax.set_ylabel("WQ [m³/s]")
ax.grid(True, axis="y", alpha=0.3)
ax.legend(loc="upper center", ncol=2, fontsize=9, framealpha=0.9)
ax.margins(x=0.01)
fig.tight_layout()
plt.show()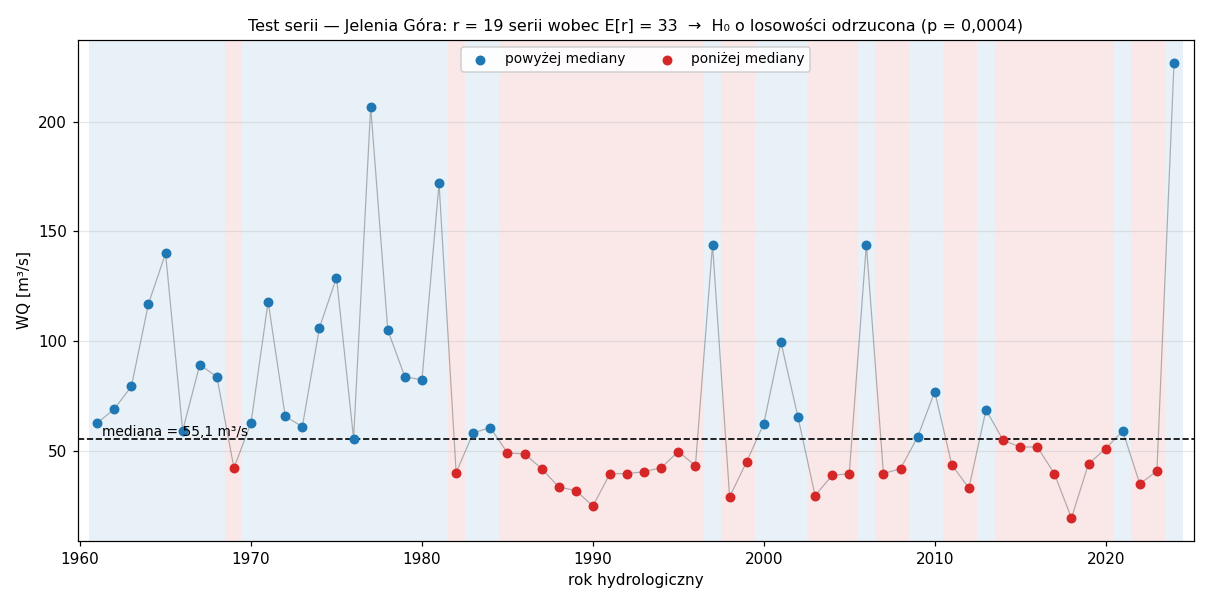
Kolor od razu tłumaczy statystykę: 12-letnia seria powyżej mediany (1970–1981) i równie długa poniżej (1985–1996) to nie losowe fluktuacje, lecz dwa reżimy rozdzielone skokiem około 1982 roku. Losowy ciąg zmieniałby stronę znacznie częściej — stąd .
Wersja biblioteczna
Test serii oferuje
statsmodels(statsmodels.sandbox.stats.runs.runstest_1samp), ale nie ma go w naszym środowisku i nie należy do „zestawu podstawowego”. Implementacja ręczna to jednocześnie test i wyjaśnienie — dlatego zostajemy przy niej.
5.3. Autokorelacja (korelacja wewnętrzna)
Test serii bada losowość „chwilową”; autokorelacja wykrywa liniową zależność między sąsiednimi latami. Współczynnik autokorelacji rzędu 1 z estymatorem nieobciążonym (I.6) i granicami przedziału (I.7):
def autocorrelation(x, alpha=0.05):
    x = np.asarray(x, dtype=float)
    N = len(x)
    xbar = x.mean()
    c0 = np.sum((x - xbar)**2) / N
    c1 = np.sum((x[:-1] - xbar) * (x[1:] - xbar)) / N
    r1 = c1 / c0
    r1_hat = (N + 1) / (N - 4) * r1
    tq = norm.ppf(1 - alpha / 2)  # t_{α/2} jako kwantyl N(0,1)
    lower = (-1 - tq * np.sqrt(N - 2)) / (N - 1)
    upper = (-1 + tq * np.sqrt(N - 2)) / (N - 1)
    return dict(r1=r1, r1_hat=r1_hat, lower=lower, upper=upper,
                reject=(r1_hat <= lower or r1_hat >= upper))
w = autocorrelation(jg)
print(f"r1 = {w['r1']:.4f}, r1 (nieobciążone) = {w['r1_hat']:.4f}")
print(f"przedział ufności: [{w['lower']:.4f}, {w['upper']:.4f}]")
print(f"odrzucić H0 o braku autokorelacji: {w['reject']}")r1 = 0.1127, r1 (nieobciążone) = 0.1221
przedział ufności: [-0.2608, 0.2291]
odrzucić H0 o braku autokorelacji: FalseEstymator nieobciążony mieści się w przedziale , więc nie odrzucamy hipotezy o braku autokorelacji — zależność między sąsiednimi latami jest nieistotna. To ważne: skok w środku ciągu nie musi generować silnej korelacji sąsiednich lat, bo jest to struktura długozasięgowa (całe dziesięciolecia po jednej stronie), którą wyłapał dopiero test serii, a nie autokorelacja rzędu 1.
Porównajmy z pandas, który liczy autokorelację jako zwykłą korelację Pearsona między ciągiem a jego przesunięciem:
print(f"pandas Series.autocorr(1) = {pd.Series(jg).autocorr(lag=1):.4f}")pandas Series.autocorr(1) = 0.1283Wartości nieco się różnią (0,122 vs 0,128), bo normalizacja jest inna: wzór I.6 dzieli autokowariancję przez i stosuje poprawkę na obciążenie, a pandas liczy współczynnik Pearsona dwóch przesuniętych podciągów.
5.4. Test Kruskala-Wallisa (stacjonarność rozkładu)
Ten test sprawdza, czy podciągi pochodzą z tego samego rozkładu. W odróżnieniu od innych testów (Pettitt, SNHT) nie lokalizuje sam punktu podziału — trzeba go wskazać a priori. Z Etapu I mamy taki punkt: rok 1982. Dzielimy ciąg na „przed” i „po”, rangujemy wszystkie wartości łącznie i porównujemy sumy rang (I.8):
z poprawką na remisy , gdzie .
def kruskal_wallis(groups, alpha=0.05):
    groups = [np.asarray(g, dtype=float) for g in groups]
    all_values = np.concatenate(groups)
    N = len(all_values)
    ranks = rankdata(all_values)  # rangi uśrednione dla remisów
    H = 0.0
    i = 0
    for g in groups:
        ni = len(g)
        Ti = ranks[i:i + ni].sum()
        H += Ti**2 / ni
        i += ni
    chi2 = 12.0 / (N * (N + 1)) * H - 3 * (N + 1)
    _, counts = np.unique(all_values, return_counts=True)
    c = 1 - sum(t**3 - t for t in counts) / (N**3 - N)  # poprawka na remisy
    chi2_c = chi2 / c
    df = len(groups) - 1
    p = 1 - chi2_dist.cdf(chi2_c, df)
    return dict(chi2=chi2, chi2_c=chi2_c, c=c, df=df, p=p, reject=p < alpha)
before = jg[years_jg < 1982]
after = jg[years_jg >= 1982]
w = kruskal_wallis([before, after])
print(f"n(przed) = {len(before)}, n(po) = {len(after)}")
print(f"chi2 = {w['chi2']:.4f}, chi2 z poprawką = {w['chi2_c']:.4f}, df = {w['df']}")
print(f"p = {w['p']:.6f} -> odrzucić H0 o stacjonarności: {w['reject']}")n(przed) = 21, n(po) = 43
chi2 = 22.7390, chi2 z poprawką = 22.7510, df = 1
p = 0.000002 -> odrzucić H0 o stacjonarności: TrueRozkłady „przed” i „po” 1982 różnią się bardzo istotnie (). Sprawdźmy to funkcją scipy.stats.kruskal, która stosuje tę samą poprawkę na remisy:
H, p = kruskal(before, after)
print(f"scipy: H = {H:.4f}, p = {p:.6f}")
scipy: H = 22.7510, p = 0.000002Nasza statystyka z poprawką (22,751) i scipy (22,751) są identyczne.
5.5. Test Spearmana — trend wartości średniej
Współczynnik korelacji rangowej Spearmana mierzy monotoniczny związek między czasem a wartością. Każdy rok ma przypisaną rangę chronologiczną oraz rangę wartości ; różnice wchodzą do wzoru (I.9, tu w postaci ogólnej z centrowanymi sumami kwadratów rang):
gdzie sumy , liczone są od średniej rangi (bez remisów równe ), a ma rozkład Studenta o stopniach swobody.
def spearman_trend(values, alpha=0.05):
    values = np.asarray(values, dtype=float)
    N = len(values)
    x = np.arange(1, N + 1, dtype=float)  # ranga chronologiczna (rok)
    y = rankdata(values)  # ranga wartości
    d = x - y
    sx2 = np.sum((x - x.mean())**2)
    sy2 = np.sum((y - y.mean())**2)
    sd2 = np.sum(d**2)
    rs = (sx2 + sy2 - sd2) / (2 * np.sqrt(sx2 * sy2))
    t = rs * np.sqrt((N - 2) / (1 - rs**2))
    p = 2 * (1 - t_dist.cdf(abs(t), N - 2))
    return dict(rs=rs, t=t, df=N - 2, p=p, reject=p < alpha)
w = spearman_trend(jg)
print(f"rs = {w['rs']:.5f}, t = {w['t']:.4f}, df = {w['df']}, p = {w['p']:.5f}")
print(f"odrzucić H0 o braku trendu: {w['reject']}")rs = -0.41332, t = -3.5740, df = 62, p = 0.00069Ujemne przy oznacza istotny malejący trend. Weryfikacja scipy — korelacja rang między numerem roku a wartością to dokładnie to samo:
rho, p = spearmanr(np.arange(len(jg)), jg)
print(f"scipy: rho = {rho:.5f}, p = {p:.5f}")
scipy: rho = -0.41332, p = 0.00069Ten sam wynik da pd.Series(jg).corr(pd.Series(np.arange(len(jg))), method="spearman").
5.6. Test Spearmana — trend wariancji
Ten sam schemat, ale na przekształconym ciągu (odległości od średniej), wykrywa zmianę rozproszenia (I.10):
def spearman_variance(values, alpha=0.05):
    values = np.asarray(values, dtype=float)
    z = (values - values.mean())**2
    return spearman_trend(z, alpha=alpha)
w = spearman_variance(jg)
print(f"rs = {w['rs']:.5f}, p = {w['p']:.5f} -> trend wariancji: {w['reject']}")rs = 0.10930, p = 0.38993 -> trend wariancji: FalseWariancja jest stabilna — zmienił się tylko poziom (średnia), nie rozrzut. To spójne z hipotezą skoku wartości centralnej.
5.7. Test Manna-Kendalla (metodyka KZGW)
Na koniec test wskazany przez metodykę KZGW (2017) — nieparametryczny test trendu monotonicznego. Sumuje znaki wszystkich par (I.2), z poprawką na remisy w wariancji:
def mann_kendall(x, alpha=0.05):
    x = np.asarray(x, dtype=float)
    n = len(x)
    S = 0
    for i in range(n - 1):
        S += np.sign(x[i + 1:] - x[i]).sum()
    S = int(S)
    _, counts = np.unique(x, return_counts=True)
    correction = sum(t * (t - 1) * (2 * t + 5) for t in counts if t > 1)
    var_s = (n * (n - 1) * (2 * n + 5) - correction) / 18.0
    if S > 0:
        Z = (S - 1) / np.sqrt(var_s)
    elif S < 0:
        Z = (S + 1) / np.sqrt(var_s)
    else:
        Z = 0.0
    p = 2 * (1 - norm.cdf(abs(Z)))
    return dict(S=S, var_s=var_s, Z=Z, p=p, reject=p < alpha)
w = mann_kendall(jg)
print(f"S = {w['S']}, Var(S) = {w['var_s']:.1f}, Z = {w['Z']:.4f}, p = {w['p']:.5f}")
print(f"odrzucić H0 o braku trendu: {w['reject']}")S = -545, Var(S) = 29772.3, Z = -3.1528, p = 0.00162Weryfikacja gotowym pakietem pymannkendall:
result = mk.original_test(jg)
print(f"pymannkendall: S = {result.s:.0f}, Var(S) = {result.var_s:.1f}, "
      f"Z = {result.z:.4f}, p = {result.p:.5f}, trend = {result.trend}")
pymannkendall: S = -545, Var(S) = 29772.3, Z = -3.1528, p = 0.00162, trend = decreasingIdealna zgodność. Zauważ, że , , i są dokładnie takie same — nasza „ręczna” funkcja liczy to samo, co pakiet, tylko jawnie.
Autokorelacja a Mann-Kendall
Wzór na zakłada niezależność obserwacji. Dodatnia autokorelacja zawyża i grozi fałszywym wykryciem trendu — dlatego test autokorelacji (5.3) wykonuje się przed interpretacją MK. Dla Jeleniej Góry autokorelacja była nieistotna, więc wynik MK jest wiarygodny. Przy istotnej autokorelacji stosuje się korektę Hameda-Rao:
mk.hamed_rao_modification_test.
5.8. Sekwencyjny Mann-Kendall — lokalizacja zmiany (Mann-Kendall-Sneyers)
Zwykły Mann-Kendall mówi tylko, czy jest trend — nie kiedy się zaczął. Sekwencyjny wariant Sneyersa (MKS) to uzupełnia, wciąż w rodzinie Manna-Kendalla. Liczy dwie standaryzowane serie: progresywną (narastająco od początku ciągu) i wsteczną (z ciągu odwróconego). Ich przecięcie wskazuje przybliżony rok zmiany. O istotności trendu nie rozstrzyga przy tym chwilowy szczyt ścieżki , lecz zwykły Mann-Kendall — a ściślej jego końcowa wartość , równa statystyce (wrócimy do tej pułapki niżej).
Dla każdego wyrazu liczymy — liczbę wcześniejszych wyrazów mniejszych od — i sumę narastającą :
Serię wsteczną otrzymujemy tą samą procedurą na ciągu odwróconym, po czym odwracamy kolejność wyników i zmieniamy znak.
def sequential_mk(x):
    """Sekwencyjny test Manna-Kendalla (Sneyers):
    serie u(t) progresywna i u'(t) wsteczna."""
    x = np.asarray(x, dtype=float)

    def u_progressive(series):
        n = len(series)
        m = np.array([np.sum(series[:k] < series[k]) for k in range(n)])  # m_k
        S = np.cumsum(m)  # S_k = Σ m_i
        k = np.arange(1, n + 1)
        E = k * (k - 1) / 4.0
        Var = k * (k - 1) * (2 * k + 5) / 72.0
        u = np.zeros(n)
        u[Var > 0] = (S[Var > 0] - E[Var > 0]) / np.sqrt(Var[Var > 0])
        return u

    uf = u_progressive(x)
    ub = -u_progressive(x[::-1])[::-1]  # odwróć ciąg, policz, odwróć wynik i zmień znak
    return uf, ub
def change_years(years, uf, ub):
"""Lata, w których u(t) i u'(t) się przecinają (interpolacja liniowa)."""
d = uf - ub
changes = []
for i in range(1, len(d)):
if d[i - 1] * d[i] < 0:
frac = abs(d[i - 1]) / (abs(d[i - 1]) + abs(d[i]))
changes.append(years[i - 1] + frac * (years[i] - years[i - 1]))
return changesKontrola poprawności
Ostatnia wartość serii progresywnej jest równa statystyce zwykłego Manna-Kendalla (bez poprawki na ciągłość). Dla Jeleniej Góry , zgodnie z — to potwierdza, że stałe we wzorach są dobre.
uf, ub = sequential_mk(jg)
changes = change_years(years_jg, uf, ub)
print("przecięcia u(t)/u'(t) w latach:", [round(r) for r in changes])
print(f"u(t_n) = {uf[-1]:.2f}   (= Z zwykłego MK)    "
      f"max|u(t)| = {np.max(np.abs(uf)):.2f}")
przecięcia u(t)/u'(t) w latach: [1982]
u(t_n) = -3.23 (= Z zwykłego MK) max|u(t)| = 3.68Jedno, czyste przecięcie w 1982 roku, a końcowe pokrywa się ze statystyką zwykłego Manna-Kendalla — trend maleje i jest istotny. To wzorcowy obraz zlokalizowanej, potwierdzonej zmiany: nie chwilowy wyskok ścieżki, lecz trwałe zejście poniżej progu aż do końca ciągu.
Uruchommy MKS na wszystkich stacjach:
for name in wq.columns:
    years_s, x = series(name)
    uf_s, ub_s = sequential_mk(x)
    changes_s = [round(r) for r in change_years(years_s, uf_s, ub_s)]
    p_mk = mann_kendall(x)["p"]  # istotność trendu — ze zwykłego MK
    trend = "istotny" if p_mk < 0.05 else "brak"
    print(f"{name:13} max|u(t)|={np.max(np.abs(uf_s)):.2f}  "
          f"trend MK: {trend:7} (p={p_mk:.3f})  przecięcia={changes_s}")
Jakuszyce max|u(t)|=2.41 trend MK: brak (p=0.424) przecięcia=[1996, 1998, 1998, 2017, 2019, 2022, 2023]
Piechowice max|u(t)|=1.62 trend MK: brak (p=0.300) przecięcia=[1964, 1965, 1978, 1978, 1980, 1981, 1983, 1984, 1994, 2017, 2019, 2021, 2023]
Jelenia Góra max|u(t)|=3.68 trend MK: istotny (p=0.002) przecięcia=[1982]Uwaga na kolumnę max|u(t)|: nie jest ona miarą istotności. Rozstrzyga zwykły MK (trend MK), a MKS służy wyłącznie do lokalizacji ewentualnej zmiany (kolumna przecięcia).
Kontrast jest wymowny:
- Jelenia Góra — jedno przecięcie (1982), a zwykły MK potwierdza istotny malejący trend () → wyraźnie zlokalizowana, potwierdzona zmiana w 1982 roku.
- Piechowice — przecięć jest wiele i są rozrzucone, a MK nie wykrywa trendu (): to błądzenie serii jednorodnej, bez punktu zmiany.
- Jakuszyce — tu uwaga. przekracza 1,96, ale to nie dowód zmiany. Zwykły MK daje (brak trendu), a przecięcia są rozproszone. Szczyt bierze się z naturalnej zmienności serii, nie ze zmiany reżimu (rozwinięcie niżej).
Pułapka: to nie test istotności
Kusi, by uznać, że skoro gdzieś przekroczyło , to trend jest istotny. To błąd wielokrotnych porównań. Ścieżka ma silnie skorelowanych punktów; pod hipotezą zerową (brak zmiany) jej maksimum i tak wychodzi poza znacznie częściej niż w 5% przypadków — próg dotyczy pojedynczego testu, nie maksimum całej ścieżki. O istotności trendu rozstrzyga końcowa wartość (równa statystyce zwykłego MK), a o zmianie — trwałe przecięcie z , nie chwilowy szczyt. Jakuszyce są tego przykładem: , ale i MK → seria jednorodna.
Skąd zatem szczyt u Jakuszyc? To najkrótszy z trzech ciągów (n = 44, od 1981) i zarazem najzmienniejszy — współczynnik zmienności , wobec dla Piechowic i dla Jeleniej Góry. Po wysokich wezbraniach z początku lat 80. (WQ 1981 m³/s) przyszła seria niżowa przełomu dekad (WQ 1987 i 1990 m³/s — najniższe w całym ciągu), a potem powrót do wysokich stanów (WQ 2010 m³/s). Właśnie na tym dołku, około 1990 roku, sięga — przy małym statystyka narastająca reaguje gwałtownie na kilka niskich lat z rzędu. Do końca ciągu wszystko się „odkręca”: . To naturalna zmienność, nie trwała zmiana reżimu.
Najlepiej widać to na wykresie — po jednym panelu na stację:
fig, axes = plt.subplots(3, 1, figsize=(10, 11), sharex=True)
for ax, name in zip(axes, wq.columns):
    years_s, x = series(name)
    uf_s, ub_s = sequential_mk(x)
    ax.plot(years_s, uf_s, "-", color="#d62728", lw=1.4, label="u(t) — progresywna")
    ax.plot(years_s, ub_s, "--", color="#1f77b4", lw=1.4, label="u'(t) — wsteczna")
    for y in (1.96, -1.96):
        ax.axhline(y, color="grey", ls=":", lw=1)
    ax.axhline(0, color="black", lw=0.6)
    ax.set_title(f"{name}  (max|u(t)| = {np.max(np.abs(uf_s)):.2f})", fontsize=10)
    ax.set_ylabel("u")
    ax.grid(True, alpha=0.3)
# pionowa linia w miejscu przecięcia dla Jeleniej Góry
axes[2].axvline(1982, color="green", ls="--", lw=1.2, alpha=0.7)
axes[0].legend(loc="upper right", fontsize=8)
axes[-1].set_xlabel("rok hydrologiczny")
fig.suptitle("Sekwencyjny Mann-Kendall (Sneyers) — WQ trzech stacji")
fig.tight_layout()
plt.show()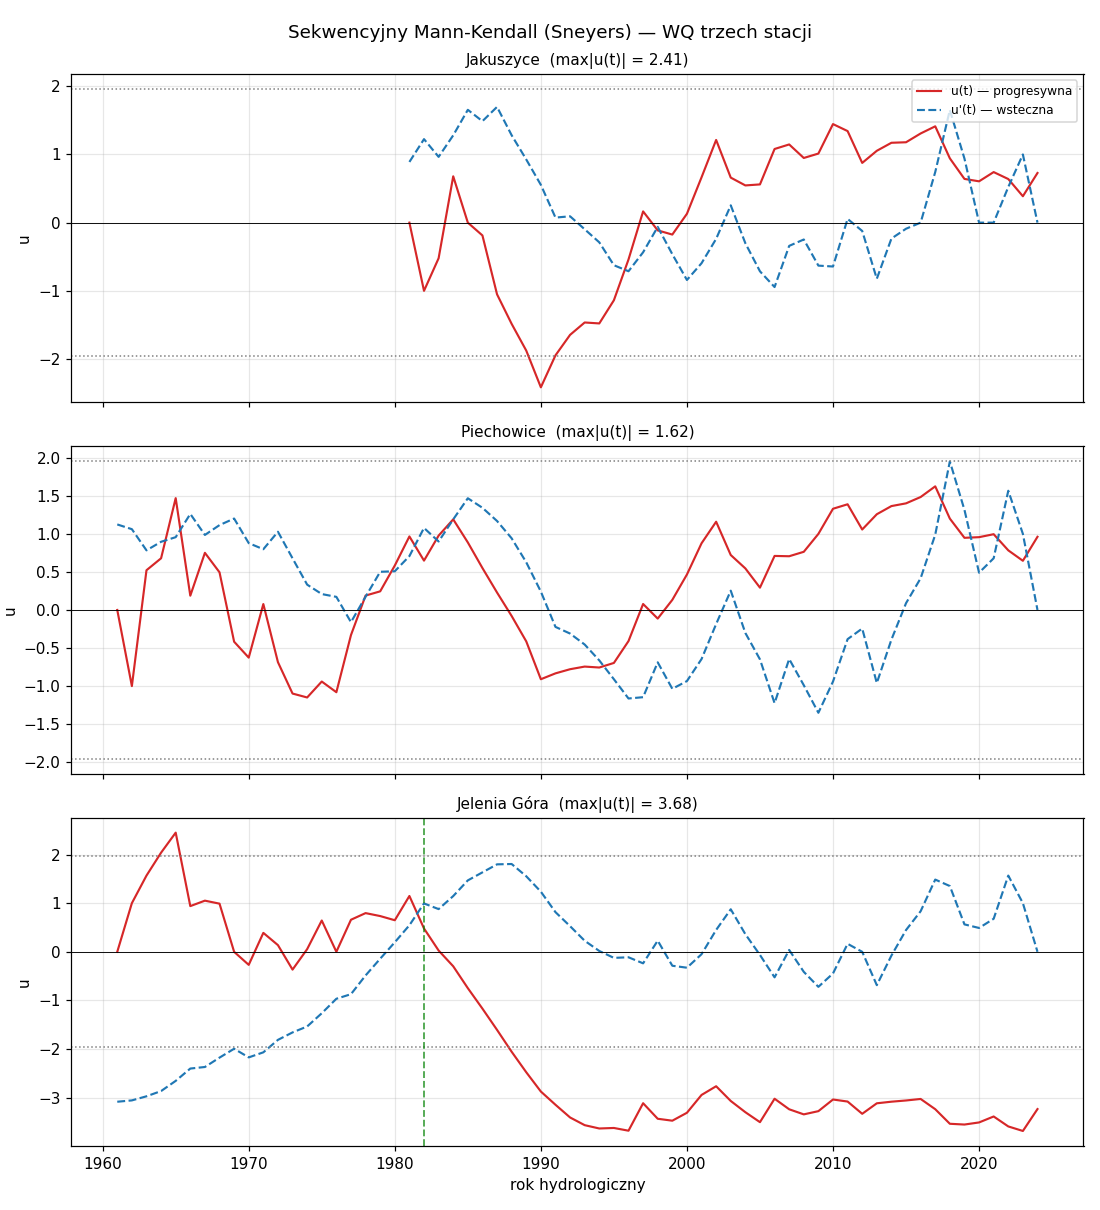
Te panele uzupełniają krzywą podwójnie kumulowaną z sekcji 4. Pokazała ona zmianę w relacji Jeleniej Góry do stacji odniesienia (metoda względna, para stacji), a MKS — że tylko dolna stacja ma własny punkt zmiany w tym samym roku (metoda bezwzględna, każda seria z osobna). Dwa niezależne spojrzenia wskazują to samo: lokalną niejednorodność wodowskazu Jelenia Góra około 1982 roku.
Pułapkę wielokrotnych porównań łatwo zobaczyć liczbowo. Wygenerujmy tysiące serii białego szumu (brak jakiejkolwiek zmiany, prawdziwa) o długości naszych ciągów i policzmy, jak często ścieżka przekracza — osobno w dowolnym punkcie i osobno na końcu:
# Ilustracja: pod H0 (brak zmiany) — jak często u(t) przebija ±1,96?
rng = np.random.default_rng(42)
def exceedance_fractions(n, n_sym=5000):
max_hits = end_hits = 0
for _ in range(n_sym):
u, _ = sequential_mk(rng.standard_normal(n)) # seria bez trendu
max_hits += np.max(np.abs(u)) > 1.96 # gdziekolwiek na ścieżce
end_hits += abs(u[-1]) > 1.96 # tylko punkt końcowy = zwykły MK
return max_hits / n_sym, end_hits / n_symfor n in (44, 64): # długości naszych ciągów
p_max, p_end = exceedance_fractions(n)
print(f"n={n}: P(max|u(t)|>1.96) = {p_max:.1%} P(|u(t_n)|>1.96) = {p_end:.1%}")n=44: P(max|u(t)|>1.96) = 45.3% P(|u(t_n)|>1.96) = 5.0%
n=64: P(max|u(t)|>1.96) = 51.0% P(|u(t_n)|>1.96) = 4.9%Punkt końcowy trzyma się nominalnych 5% — to uczciwy pojedynczy test (i dokładnie on odpowiada zwykłemu MK). Ale maksimum całej ścieżki przebija próg w niemal połowie przypadków, choć żadna z tych serii nie zawiera zmiany. Stąd u Jakuszyc to nie sygnał, lecz normalny szum skorelowanej ścieżki.
MKS jako potwierdzenie, nie źródło podziału
Rok 1982 do testu Kruskala-Wallisa wzięliśmy a priori z porównania ze stacją odniesienia (sekcja 4) — argumentu zewnętrznego wobec badanej serii. MKS, który sam „wyciąga” z niej 1982, jest niezależnym potwierdzeniem tej daty w rodzinie Manna-Kendalla, ale nie używamy go do redefiniowania podziału (to byłoby rozumowanie w kółko). Metoda pochodzi od Sneyersa (1990); szerzej w części teoretycznej Badanie jednorodności ciągów hydrologicznych.
6. Cała procedura dla trzech stacji
Zbierzmy testy w jedną funkcję i uruchommy na wszystkich stacjach. Dla Kruskala-Wallisa punkt podziału bierzemy z Etapu I: 1982 dla Piechowic i Jeleniej Góry (te same lata, wspólna rzeka); dla Jakuszyc — które startują dopiero w 1981 i nie mają wskazanej przesłanki genetycznej — dzielimy ciąg na połowy jako zwykłą kontrolę stacjonarności.
def assess(name, split_year=1982):
    years, x = series(name)
    if (years < split_year).sum() < 5:  # za mało danych sprzed podziału
        split_year = int(np.median(years))  # -> podział na połowy (kontrola)
    before, after = x[years < split_year], x[years >= split_year]
    return {
        "n": len(x),
        "podział": split_year,
        "Mann-Kendall": mann_kendall(x)["reject"],
        "Spearman (średnia)": spearman_trend(x)["reject"],
        "Spearman (wariancja)": spearman_variance(x)["reject"],
        "test serii": runs_test(x)["reject"],
        "autokorelacja": autocorrelation(x)["reject"],
        "Kruskal-Wallis": kruskal_wallis([before, after])["reject"],
    }
table = pd.DataFrame({n: assess(n) for n in wq.columns}).T
print(table.to_string()) n podział Mann-Kendall Spearman (średnia) Spearman (wariancja) test serii autokorelacja Kruskal-Wallis
Jakuszyce 44 2002 False False False False False False
Piechowice 64 1982 False False False True False False
Jelenia Góra 64 1982 True True False True False TrueKolumna podział to rok użyty do testu Kruskala-Wallisa: dla Piechowic i Jeleniej Góry — wskazany a priori 1982; dla Jakuszyc — mediana lat (2002), bo przed 1982 mają tylko jeden rok, a test wymaga podciągów liczniejszych niż 5. True oznacza „odrzuć hipotezę o jednorodności”, czyli sygnał niejednorodności.
Obraz jest czytelny:
- Jakuszyce — wszystkie testy
False. Ciąg jednorodny. Górna, niemal naturalna stacja zachowuje się dokładnie tak, jak powinna — to potwierdza, że nasza procedura działa (test na kontroli negatywnej). - Piechowice — brak trendu i zmiany rozkładu, ale test serii sygnalizuje odstępstwo od losowości. To nie skok, lecz wieloletnia klasteryzacja (naprzemienne okresy bogatsze i uboższe w wezbrania).
- Jelenia Góra — trend (MK, Spearman), skok rozkładu (Kruskal-Wallis) i brak losowości (serii) zgodnie wskazują niejednorodność, przy stabilnej wariancji (zmiana dotyczy poziomu, nie rozrzutu). Wszystko spójne z hipotezą skoku wartości centralnej w 1982 roku.
7. Wnioski
Studium trzech wodowskazów Kamiennej pokazuje, jak działa procedura badania jednorodności w praktyce:
- Stacja odniesienia uwiarygadnia metodę. Jakuszyce (najbliższe naturze) wychodzą jednorodne — gdyby testy „widziały” niejednorodność wszędzie, nie ufalibyśmy im.
- Testy wykrywają, analiza genetyczna wyjaśnia. W Jeleniej Górze zgodny sygnał wielu testów wskazuje skok około 1982 roku. Sam skok to jednak dopiero pytanie: porównanie ze stacją odniesienia (zanik różnicy maksimów z 2,3× do ~1,25×) i brak budowli z tego okresu każą podejrzewać zmianę pomiarową (krzywa przepływu / przeniesienie wodowskazu) — hipotezę do potwierdzenia!
- Jednorodność to nie to samo co naturalność. Wszystkie trzy rzeki są w jakimś stopniu przekształcone (MEW, zbiorniki), a mimo to Jakuszyce i Piechowice mają jednorodne ciągi maksimów. Homogeniczność dotyczy stałości w czasie, nie braku ingerencji — jeśli budowla działała przez cały okres obserwacji (jak historyczny zbiornik Sobieszów), ciąg może pozostać jednorodny.
Poboczny wątek — niżówki
Wybraliśmy WQ (maksima). Gdyby analizować minima roczne (NQ), obraz byłby inny: w Piechowicach przepływy minimalne istotnie maleją (Mann-Kendall ), co może wiązać się z poborem wody i suszą — sygnał niewidoczny w maksimach. To dobra ilustracja, że jednorodność bada się dla konkretnej zmiennej. Serię NQ zbudujesz tą samą funkcją
pobierz_wq, biorąc w niej ekstremum1(minimum) zamiast3imin(...)zamiastmax(...).
8. Ograniczenia i dobre praktyki
- Podział a priori vs a posteriori. Kruskal-Wallis i Mann-Whitney wymagają wskazania punktu podziału z góry (z analizy genetycznej), a nie „dopasowania” go do danych. Wskazanie roku po obejrzeniu wykresu tej samej serii byłoby rozumowaniem w kółko. Rok 1982 wzięliśmy z porównania ze stacją odniesienia, nie z samej Jeleniej Góry — i wyraźnie oznaczyliśmy go jako hipotezę. Do formalnej lokalizacji punktu zmiany służą testy Pettitt/SNHT/Buishand — patrz Badanie jednorodności ciągów hydrologicznych.
- Autokorelacja i Mann-Kendall. Zawsze sprawdzaj autokorelację przed interpretacją MK; przy istotnej stosuj korektę Hameda-Rao.
- Test serii jest czuły na klasteryzację. Jego odrzucenie nie zawsze oznacza trend czy skok — może wskazywać wieloletnią zmienność. Interpretuj wyniki łącznie, nie mechanicznie.
- Długość i jednorodność źródła. Metodyka KZGW wymaga lat. Pamiętaj też, że IMGW koryguje dane historyczne, a format plików bywa różny między rocznikami (patrz sekcja 3) — utrwalaj wersję danych, na której liczyłeś (stąd zapis do CSV).
- Hipotezy o przyczynach (skok 1982) wymagają weryfikacji. Wynik statystyczny to przesłanka, nie werdykt.
Zobacz także
- IT — indeks tematyczny
- Badanie jednorodności ciągów hydrologicznych — teoria: siedem testów, wzory I.1–I.11, procedura polska i międzynarodowa
- Rozkłady prawdopodobieństwa w analizie opadów i przepływów — kolejny krok: dopasowanie rozkładu po wykazaniu jednorodności
- IMGWTools — biblioteka do pobierania danych IMGW; struktura danych i inne interwały
- pandas — operacje na ramkach danych i szeregach czasowych użyte wyżej
- Środowisko Python dla przykładów — odtworzenie środowiska (pyenv 3.12.12 +
requirements.txt) - Statystyka — indeks metod statystycznych; Hydrologia — domena zastosowań
- Dokumentacja
scipy.stats—kruskal,spearmanr,rankdata pymannkendall(PyPI) — test Manna-Kendalla i jego warianty